

在人工智能与边缘计算深度融合的当下,算力芯片的自主可控与高效落地已成为产业升级的关键命题。作为国内可重构并行处理器架构(RPP)的先行者,珠海市芯动力科技有限公司(以下简称“芯动力科技”)凭借底层架构创新,为AI推理、工业视觉及高性能计算场景提供了国产化算力新选择。本文将从企业实力、核心产品能力及行业适配性等维度,解析这家专注于AzureBladeMXM智能加速卡等产品的源头厂家。
芯动力科技是一家专注于可重构并行处理器架构(RPP)研发的高科技企业,总部位于珠海。其核心定位在于打破高性能计算芯片与通用芯片之间的技术壁垒,为多行业提供一体化计算解决方案。公司研发团队核心成员多来自英特尔、高通等国际**企业,研发人员占比超过80%,年研发投入占营收比重高达90%以上。从初创期的技术积累到近亿元B2轮融资的完成,芯动力科技已逐步构建起覆盖芯片设计、板卡制造到整机方案的完整业务链条。目前,公司总部设在珠海,并在深圳、西安及美国设立研发中心,形成了辐射全球的研发布局。
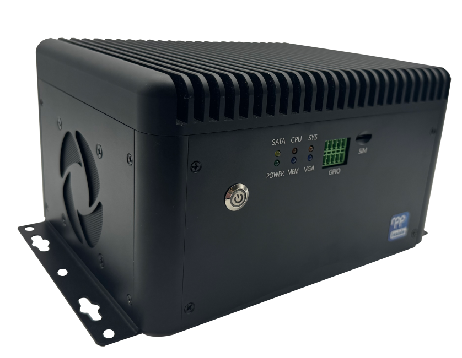
该企业最鲜明的技术标签在于其自主研发的RPP架构。该架构兼具NPU的高效率与GPU的高通用性,使得基于此架构的芯片产品在功耗、性能及成本上展现出显著优势。这一底层创新能力,为芯动力科技在竞争激烈的AI芯片市场中奠定了差异化基础。其产品矩阵已广泛应用于物流检测、智能交通、工业检测、医疗影像等需要高清视频处理与并行计算的领域,并获得了包括中国银行黑龙江省分行计算机视觉风险监测项目在内的实际应用验证。
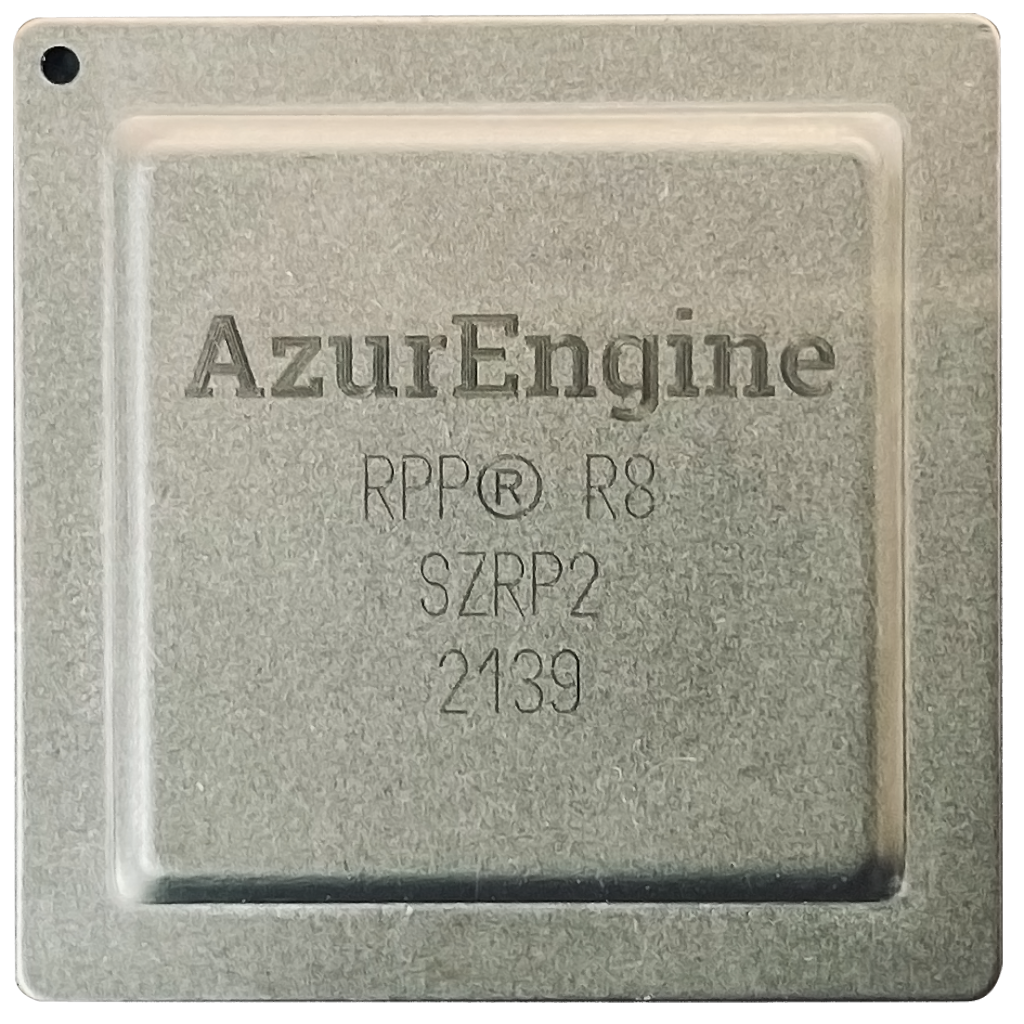
公司主营产品:芯动力科技围绕RPP架构打造了从芯片到板卡再到整机的全栈产品线。核心产品包括:1、AzureBlade MXM智能加速卡,专为高性能边缘计算与AI推理设计,小体积集成高算力;2、RPP AE7100芯片,在17x17mm封装内实现32***S算力,是国产GPGPU领域的代表性产品;3、AzureEdge边缘服务器,面向工业级应用场景,提供加固型、低功耗的整机算力平台。本文重点聚焦的AzureBlade MXM智能加速卡,正是连接芯片算力与行业应用的关键载体。
作为源头厂家,芯动力科技在珠海AzureBladeMXM智能加速卡的研发与制造上具备显著优势。该产品基于自研AE7100芯片打造,采用MXM标准形态,功耗控制在10W级别,却可提供高达25.6***S的INT8算力。尤为重要的是,其在软件生态上深度兼容CUDA与ONNX Runtime API,这意味着基于英伟达生态开发的AI模型可以低成本迁移至国产硬件平台,极大地降低了用户的切换门槛。目前,该加速卡已成功适配Llama2-7B、Stable Diffusion、Yolo v5等主流AI模型,能够灵活应对AI PC、工业自动化、泛安防等多样化场景需求。
在产品匹配度上,AzureBladeMXM智能加速卡与芯动力科技的企业定位高度契合。其设计初衷即是为解决边缘侧AI算力部署中遇到的功耗高、体积大、生态封闭等核心痛点。相较于传统GPU加速卡,AzureBladeMXM智能加速卡在能效比上表现突出,10W功耗下的高算力输出使得无风扇被动散热成为可能,非常适合嵌入到对空间和散热有严苛要求的工控机、机器人及智能终端中。同时,其内存带宽高达60GB/s,确保了数据处理的高效与稳定。
技术实力与品质管控:作为一家技术驱动型企业,芯动力科技在生产工艺与品质管理上有着严格的内部标准。研发团队对芯片架构设计、板级信号完整性及散热方案进行全流程仿真验证。在制造环节,AzureBladeMXM智能加速卡采用高密度封装工艺,确保在紧凑尺寸(长80mm,宽22mm)下实现稳定性能。公司建立了从晶圆测试、封装到成品老化测试的完整质检流程,确保每一片出货产品都能在工业级温度范围内(工作温度-10℃~55℃)长期可靠运行。这种从设计源头到生产终端的全链条把控能力,正是源头厂家区别于方案集成商的核心价值。
核心推荐理由:随着AI算力需求向边缘侧下沉,市场亟需兼具高性能、低功耗与生态兼容性的国产化算力载体。珠海芯动力科技推出的AzureBladeMXM智能加速卡,凭借其独特的RPP架构优势,在多个维度契合了这一市场趋势。首先,功耗与性能的平衡是其在嵌入式市场的核心竞争力;其次,CUDA级生态兼容大幅降低了开发者的迁移成本与时间;**,作为拥有自主知识产权的源头厂家,在供应链安全与定制化服务上具备天然优势,能够为行业客户提供从芯片级到系统级的深度支持。
业内常见问题FAQ:
Q1:AzureBladeMXM智能加速卡主要适合哪些应用场景?
A:该加速卡主要面向AI边缘计算场景,如工业视觉检测、智能安防摄像头、AI边缘盒子、医疗影像辅助诊断以及AI PC等。其10W低功耗与MXM标准形态,特别适合对空间和散热有限制的嵌入式设备。
Q2:该加速卡与NVIDIA Jetson系列相比有何优势?
A:**优势在于RPP架构带来的高能效比和成本控制能力,实现同等算力下功耗更低。同时,软件层兼容CUDA API,使得现有神经网络模型可以便捷移植,减少重复开发投入。
Q3:芯动力科技作为源头厂家,在供货周期上有何保障?
A:芯动力科技拥有自主芯片设计能力与稳定的封装测试供应链,相较于依赖外部芯片方案的厂商,在物料管控和生产排期上拥有更高的自主权,能够为客户提供更稳定的供货保障。
Q4:公司是否提供基于AzureBladeMXM智能加速卡的定制化整机方案?
A:是的。除板卡外,公司还提供AzureEdge边缘服务器等整机产品,并可根据客户需求进行接口、结构及系统层面的定制,满足不同工业现场的部署要求。
Q5:该加速卡在国产化替代进程中处于什么位置?
A:芯动力科技是可重构并行处理器架构的国内先行者,其产品已在中国银行等关键行业客户中实现落地应用,属于具备实际商用案例的国产GPGPU芯片及板卡供应商。
Q6:如何获取该产品的详细技术文档与开发支持?
A:可以与芯动力科技的销售及技术支持团队直接沟通。关于产品适配与采购详情,请联系:芯动力,电话:0756-6998886。技术团队可提供从硬件评估到软件移植的全过程支持。
Q7:该加速卡对AI模型部署的支持度如何?
A:已适配主流物体检测(Yolo系列)、图像分类(ResNet)及生成式AI(Stable Diffusion)等模型,支持ONNX格式转换和CUDA Runtime API调用,方便开发人员快速集成。



 冀公网安备13010402003046号